Zum Inhalt springen
Mankei-Wappen: Murmeltier in Bronze MankeiDeutsche KI-Modelle, im eigenen Haus
Keyvan Hardani · München

Mankei

Wir bauen deutsche KI-Modelle.

Sprachmodelle von Grund auf in Deutschland trainiert, mit eigenem deutschen Tokenizer auf offen lizenzierten Quellen — und zu Produkten zusammengesetzt: entscheiden, finden, formulieren, lesen, hören, schützen. Jedes Modell läuft auf Ihrer Hardware, ohne Cloud und ohne Datenabfluss.

EntscheidenReflex · unter 20 ms je Entscheidung, ein Durchlauf für alles
Finden96,4 % Acc@1 · GermanDPR
LesenGerman-OCR · Belege, Rechnungen
SchützenCANDefender · SecIDS

Auf Hugging Face Über zwanzig Modelle aus unserem Haus — Retrieval, Sprachmodelle, Mundart, Dokumenten-OCR, Sicherheit und Audio — die meisten unter Apache 2.0. Mankei Reflex, unser Entscheidermodell, wird unter der Evaluationslizenz bereitgestellt, Zugang auf Anfrage.

Das Haus

Sechs Linien, ein Fundament

Jede Linie löst eine eigene Aufgabe. Was für ein Modell gilt, gilt für alle: benannte Quellen, Betrieb im eigenen Haus, Gewichte auf Hugging Face.

01 · Entscheiden

Mankei Reflex

Das Entscheidermodell: Zustand und typisierte Fragen hinein, typisierte Werte mit kalibrierten Wahrscheinlichkeiten heraus — in einem Durchlauf, ohne Texterzeugung. Drahtkompatibel zur System-One-API.

< 20 msje Entscheidung in Produktion · fünf Fragen in einem Durchlauf · 100 Fragen in einer Viertelsekunde
Zur Reflex-Seite

02 · Finden

Retrieval-Familie

Embedder und Reranker für souveränes RAG: Kandidaten holen, Reihenfolge schärfen — kompakt, CPU-fähig, Apache 2.0.

96,4 %Acc@1 · GermanDPR

Zur Linie

03 · Formulieren

Sprachmodelle

Mankei-1B-Chat, von Grund auf in Deutschland trainiert, für den lokalen Betrieb als GGUF — dazu German-Text-3.1, der deutsche Text-Assistent.

23,0 %Deutsches MMLU, From-Scratch-Klasse

Zur Linie

04 · Lesen

Dokumente & Vision

German-OCR liest deutsche Dokumente: Rechnungen, Belege, Formulare — als Vision-Modell oder als schnelle Layout-OCR mit Positionen. Belegant für Belege und QR-Rechnungen.

6 ModelleGerman-OCR-3.1 bis GOCR · Apache 2.0

Zur Linie

05 · Schützen

Sicherheit & Industrie

CANDefender und SecIDS erkennen Angriffe auf dem CAN-Bus und im Netz; die Anomalieerkennung prüft Metallteile in der Fertigung — alles am Rand, ohne Cloud.

4,7 Mio.echte CAN-Frames im Training

Zur Linie

06 · Sprechen

Mundart & Audio

Mankei-Boarisch spricht Bairisch, Schwyzerdütsch steht in der Demo bereit; WakeCore erkennt das Aktivierungswort für private Sprachsysteme.

Apache 2.0Ollama, llama.cpp, vLLM · WakeCore MIT

Zur Linie

Linie 01 · Entscheiden

Mankei Reflex

Sie denken. Wir reagieren.

Das Entscheidermodell erzeugt keinen Text und keine Begründung. Zu einem Zustand und einem Satz typisierter Fragen liefert es in einem einzigen Durchlauf typisierte Werte mit kalibrierten Wahrscheinlichkeiten — deterministisch, reihenfolgeinvariant, in unter 20 Millisekunden, auf der Hardware, die ohnehin beim Kunden steht.

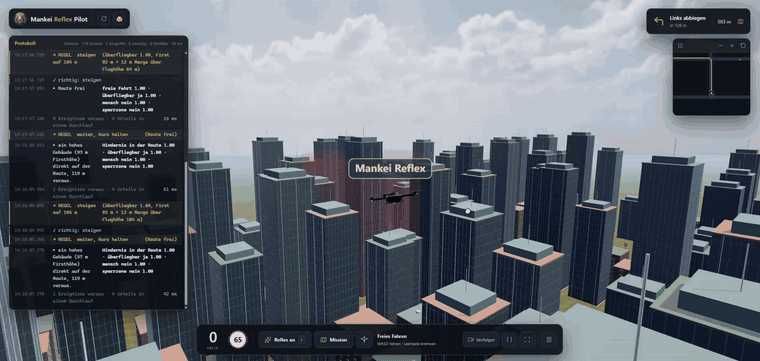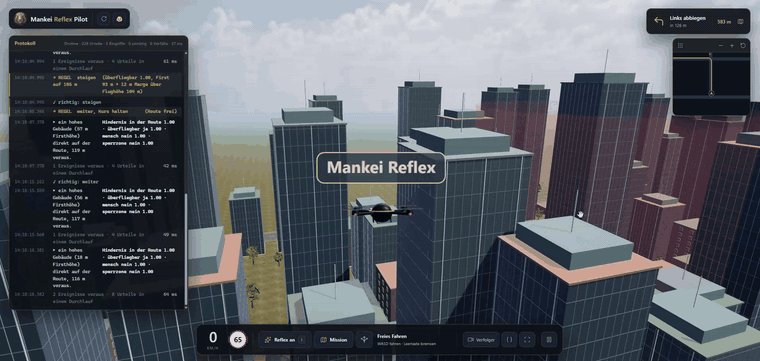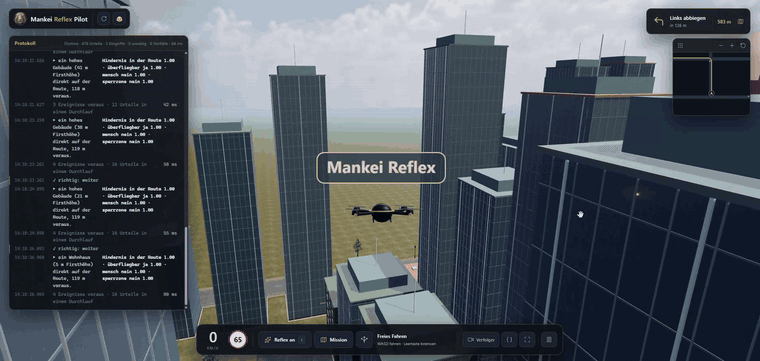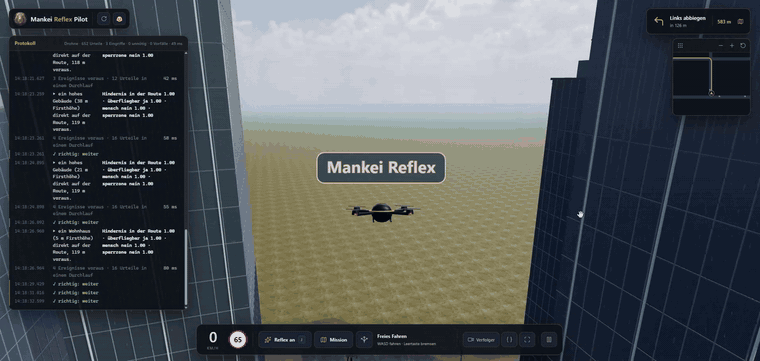
Reflex Pilot. Der Mensch setzt das Ziel auf der Karte, das Modell urteilt fortlaufend mit. Jedes Urteil steht mit Zeitstempel und Wahrscheinlichkeit im Protokoll neben der Szene.
90,5 %Trefferquote in der Domäne
95,1 %Wahl-Fragen auf ungesehenen Optionsmengen
0,031ECE · Kalibrierungsfehler, ohne Nachjustierung
67,5 %Abdeckung bei ≤ 1 % Fehler

Messprotokoll v3, acht Domänenfamilien, Leave-one-schema-out, Block „pilot“ 0.3. ECE in der Domäne 0,031, ohne Nachjustierung. Die Abdeckung ist die betriebliche Kennzahl: der Anteil der Entscheidungen, die das Modell selbständig trifft — der Rest geht an einen Menschen.

Wahl

Eine aus vielen

Eine von 2 bis 255 Optionen, mit oder ohne Beschreibung — dazu die Verteilung und die Konfidenz. Die Optionsmenge darf zur Laufzeit neu sein.

Stufe

Geordnete Skala

Ein Erwartungswert auf einer geordneten Skala: Wie dringend ist der Vorgang? → 3,4 von 5. Die Ordnung bleibt erhalten.

Janein

Eine Wahrscheinlichkeit

Die Wahrscheinlichkeit einer Aussage: Auf oder an der Fahrbahn befindet sich ein Mensch. → 0,99 — prüfbar gegen eine Schwelle.

Linie 02 · Finden

Retrieval-Familie

Souveränes RAG in zwei Stufen: Der Embedder holt die Kandidaten aus Millionen Abschnitten, der Reranker schärft die Reihenfolge der besten. Beide kompakt, beide CPU-fähig, beide unter Apache 2.0 veröffentlicht.

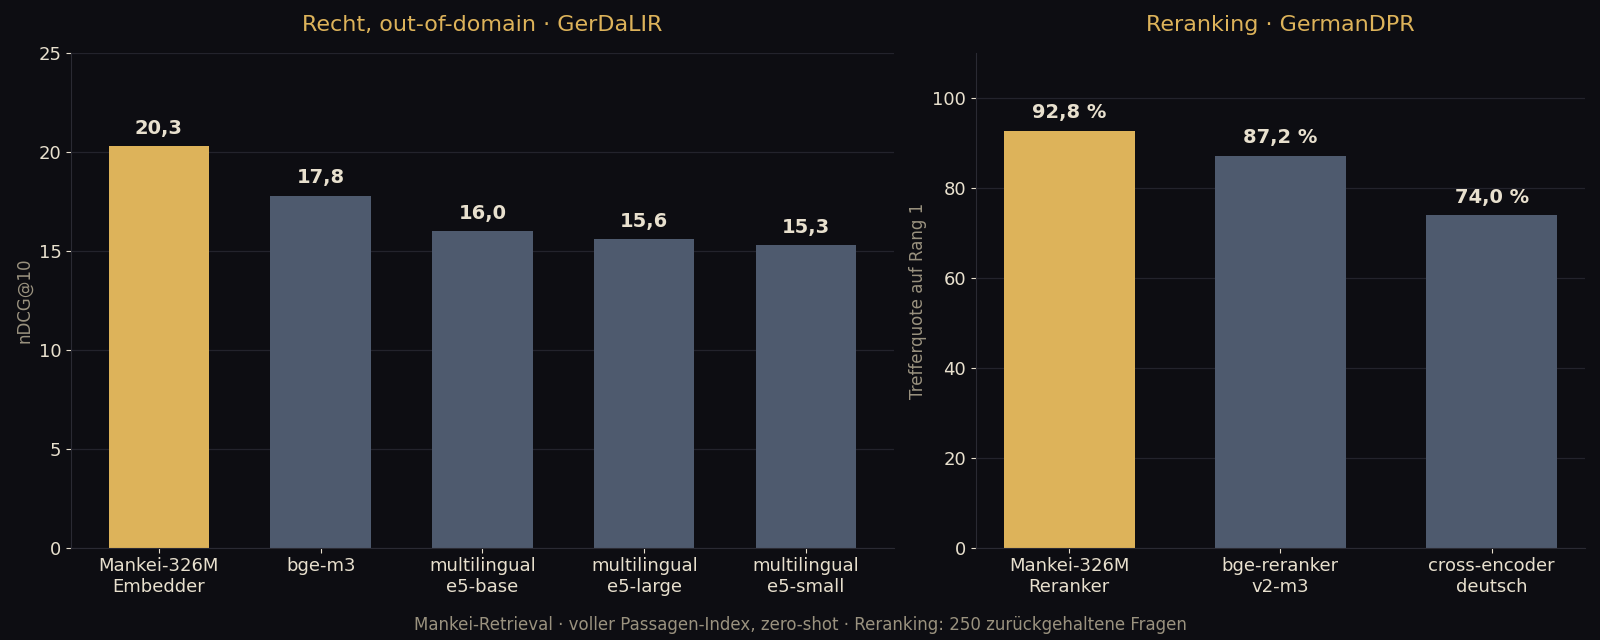
Balkendiagramm: GerDaLIR nDCG@10 — Mankei 20,3 vor bge-m3 17,8, e5-base 16,0, e5-large 15,6, e5-small 15,3. Reranking GermanDPR — Mankei 92,8 % vor bge-reranker-v2-m3 87,2 % und deutschem Cross-Encoder 74,0 %.
Gemessen, nicht behauptet. Auf echtem Rechtstext führt der Embedder vor deutlich größeren Modellen; im Reranking liegt der Cross-Encoder vor dem multilingualen Stand der Technik.
Embedder

Mankei-326M-Embedder

Deutscher Text-Embedder für on-premise-RAG: hoher Durchsatz, CPU- bis GPU-tauglich, für Millionen Abschnitte im eigenen Haus. Out-of-domain besonders belastbar — auf Fachtext führt er vor den 1,7-fach größeren Generalisten.

  • 96,4 %Acc@1 · GermanDPR, zurückgehaltene Fragen
  • 20,3nDCG@10 · GerDaLIR (Recht), vor bge-m3 17,8 und e5-large 15,6
  • 100 %GermanQuAD, out-of-domain

Auf Hugging Face

Reranker

Mankei-326M-Reranker

Deutscher Cross-Encoder: bewertet Frage-Passage-Paare und ordnet die besten Kandidaten neu — die zweite, präzise Stufe hinter dem Embedder. Listwise trainiert auf GermanDPR, die Messfragen sind vom Training ausgeschlossen.

  • 92,8 %Acc@1 · GermanDPR
  • 0,963MRR · mittlerer reziproker Rang
  • +5,6 Pp.vor bge-reranker-v2-m3 (87,2 %)

Auf Hugging Face

Benchmark · Deutsches Retrieval · GermanDPR · Treffer auf Rang 1
ModellGrößeAcc@1
Mankei-326M-Embedder0,33 B96,4 %
multilingual-e5-large0,56 B79,2 %
Qwen3-Embedding-0.6B0,60 B78,8 %
250 zurückgehaltene GermanDPR-Fragen, je 1 relevante und 5 harte Negativ-Passagen; nicht im Training. Beide Modelle der Linie werden im selben Aufbau gemessen — der Reranker erreicht in dieser Anordnung 92,8 % bei einem MRR von 0,963.
Linie 03 · Formulieren

Deutsche Sprachmodelle

Mankei-1B-Chat ist in Deutschland von Grund auf entstanden — eigener deutscher Tokenizer, eine einzelne Karte, offen lizenzierte Quellen. Es ist zugleich die Grundlage der Retrieval-Modelle und der Mundart-Linie.

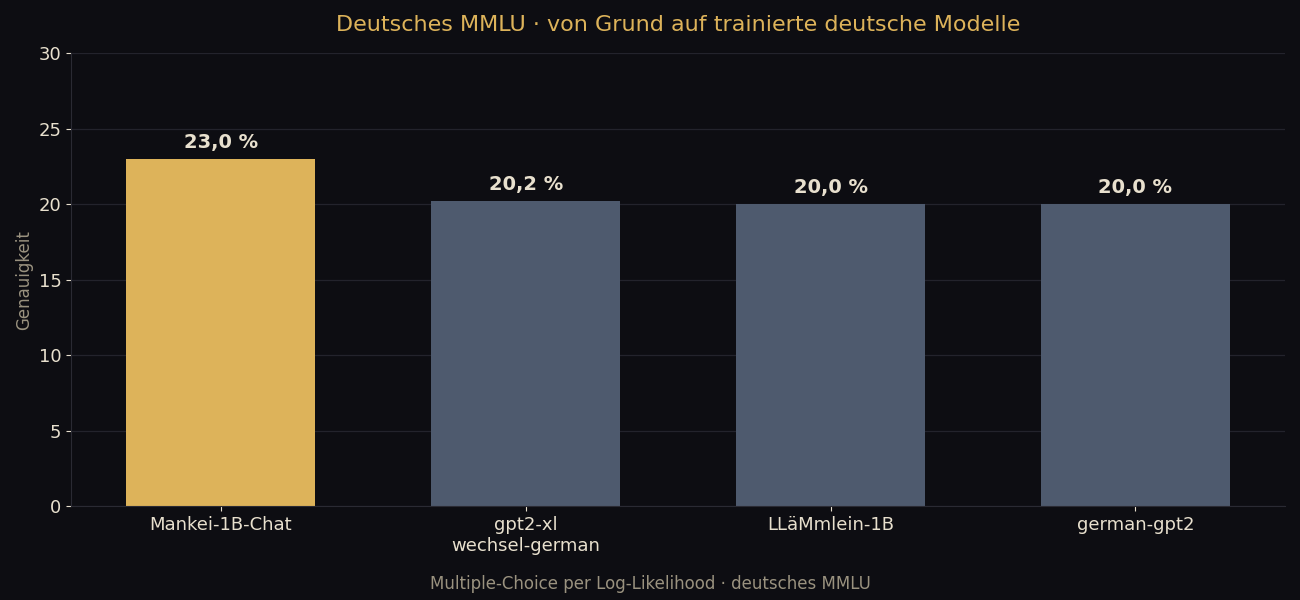
Balkendiagramm: deutsches MMLU — Mankei-1B-Chat 23,0 % vor gpt2-xl-wechsel-german 20,2 %, LLäMmlein-1B 20,0 % und german-gpt2 20,0 %.
Deutsches MMLU. Verglichen mit den anderen von Grund auf trainierten deutschen Modellen — der fairen Klasse.
  • Von Grund auf1,01 Mrd. Parameter, Llama-Architektur, Kontext 4096, Vokabular 32 768 — in Deutschland auf einer einzelnen Karte trainiert.
  • Für die CPU gebautGGUF von f16 bis Q3_K_M, ab 512 MB. Läuft über llama.cpp und Ollama auf gewöhnlicher Hardware.
  • Deutscher SprachflussFaktenabfragen auf Deutsch, Rückfrage bei Unsicherheit, flüssiges und grammatisches Deutsch.
  • Grundlage der FamilieEmbedder, Reranker und Mankei-Boarisch entstehen auf diesem Basismodell.
ollama run hf.co/keyvan-ai/Mankei-1B-Chat:Q4_K_M

Aus dem Prüfprotokoll

Juristische und amtliche Texte sind ein gezielter Schwerpunkt des Trainingskorpus. In dieser Textsorte zeigt sich das Fundament am deutlichsten.

Prüfprotokoll · Deutsches Recht · Fortsetzung durch das Basismodell
Eingabe
Nach § 433 BGB ist der Verkäufer verpflichtet,
Beobachtung

Das Basismodell setzt den Satz nahezu im Gesetzeswortlaut fort und führt die Pflichten des Verkäufers korrekt aus.

Unaufgefordert zitiert es § 439 Abs. 1 BGB — und die Kommentarliteratur: Palandt/Weidenkaff.

Linie 04 · Mundart

Dialekte des Alpenraums

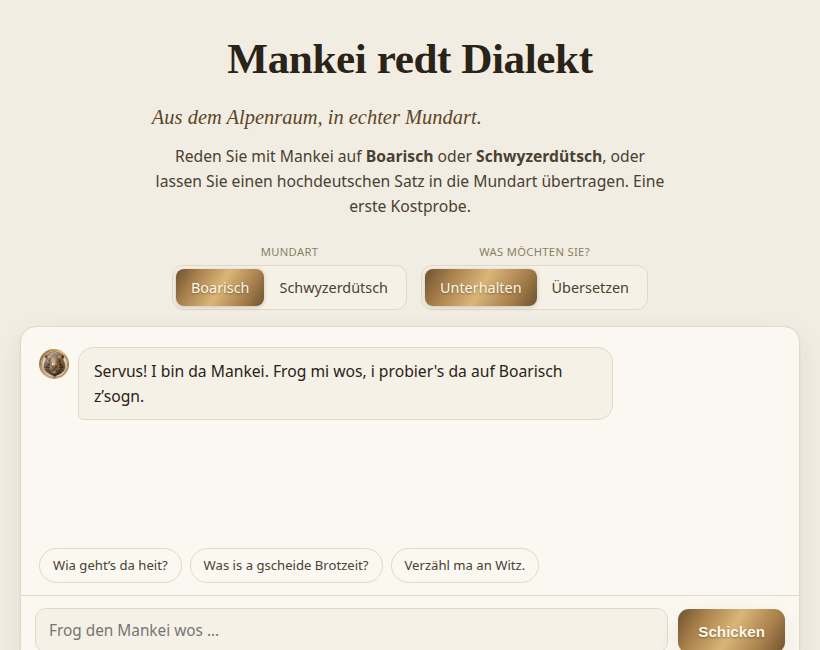
Mankei-Boarisch führt Gespräche auf Boarisch und überträgt hochdeutschen Text in die Mundart — abgeleitet aus dem deutschen Basismodell, weitertrainiert auf bairischem Text. Schwyzerdütsch steht in derselben Demo bereit.

Die Dialekt-Demo im Browser: Auswahl zwischen Boarisch und Schwyzerdütsch, Unterhalten oder Übersetzen.
Im Browser ausprobieren. Mundart wählen, unterhalten oder einen hochdeutschen Satz übertragen lassen — ohne Anmeldung.
  • KonversationAlltag, Auskunft, Ratschlag — auf Boarisch.
  • ÜbertragungHochdeutscher Text geht hinein, bairische Mundart kommt heraus.
  • Lokaler BetriebGGUF für Ollama und llama.cpp ab 637 MB, Transformers-Gewichte für vLLM auf der GPU.
  • HerkunftContinued Pretraining auf bairischem Wikipedia-Text (CC-BY-SA), danach Feinabstimmung auf bairischen Dialogen. Apache 2.0.
ollama run hf.co/keyvan-ai/Mankei-Boarisch:Q4_K_M
Boarisch

„Servus! I bin da Mankei. Frog mi wos, i probier’s da auf Boarisch z’sogn.“

Schwyzerdütsch

„Grüezi! Wottsch öppis wüsse? Frog mi eifach.“

Die Mundart wird von Sprecherinnen und Sprechern geprüft — im Dialekt-Fragebogen sammeln wir ihre Urteile.

Linie 04 · Lesen

Dokumente & Vision

Die German-OCR-Kollektion liest deutsche Dokumente dort, wo sie liegen: als Vision-Modell für Rechnungen und Formulare, als schnelle Layout-OCR mit Textpositionen, als Belegleser mit QR-Rechnung. Alles unter Apache 2.0, lokal betreibbar.

Vision-OCR

German-OCR-3.1

Das deutsche Vision-OCR-Modell der German-OCR-3-Kollektion: Rechnungsextraktion und Dokumentverständnis, als GGUF für llama.cpp. Vorgänger German-OCR-3 und German-OCR bleiben verfügbar.

Auf Hugging Face

Layout-OCR

GOCR

Klein und schnell: liest ein ganzes Dokument zu Text und Positionen (Bounding Boxes) als strukturiertes JSON — ONNX, CPU-fähig, die Vorstufe für jede Weiterverarbeitung.

Auf Hugging Face

Belege

Belegant-4B

Belege und Rechnungen inklusive Schweizer QR-Rechnung — als GGUF für den lokalen Betrieb. Dazu German-OCR-2B (GGUF), das kompakte Vision-Language-Modell für Dokumenten-OCR.

Auf Hugging Face

Linie 05 · Schützen

Sicherheit & Industrie

Modelle, die am Rand entscheiden — im Fahrzeug, im Netz, an der Linie — ohne dass ein Byte das Haus verlässt. Für Reflex sind sie die natürlichen Nachbarn: Erkennen und Entscheiden in derselben Millisekunde.

Fahrzeug

CANDefender

Einbruchserkennung auf dem CAN-Bus: ein Modell für DoS-Angriffe (rund 4,6 Millionen echte CAN-Frames im Training), eines für Fuzzy-Angriffe (4,73 Millionen). Läuft im Fahrzeug.

Auf Hugging Face

Netz & Fahrzeug

SecIDS

SecIDS-CNN: ein Faltungsnetz für Intrusion-Detection-Systeme; SecIDS-v2: die zeitliche Weiterentwicklung für Automotive-IDS mit Merkmalen wie der Zeit zwischen Frames.

Auf Hugging Face

Fertigung

Anomalieerkennung Metall

Erkennt Abweichungen an Metallteilen in der Produktion (MVTec-AD), Deep Learning mit OpenVINO-Runtime für den Betrieb auf Industrie-PCs.

Auf Hugging Face

Übersicht

Alle Modelle auf Hugging Face

Der Katalog unseres Hauses unter huggingface.co/keyvan-ai.

Modelle · Linie · Lizenz
ModellLinieAufgabeLizenz
Mankei-ReflexEntscheidenEntscheidermodell, typisiert und kalibriertEvaluationslizenz, auf Anfrage
Mankei-326M-EmbedderFindenDeutscher Text-Embedder für RAGApache 2.0
Mankei-326M-RerankerFindenCross-Encoder-RerankerApache 2.0
Mankei-1B-Chat · GGUFFormulierenDeutsches Chatmodell, CPU-fähigApache 2.0
German-Text-3.1FormulierenDeutscher Text-Assistent (German-OCR-3-Kollektion)Apache 2.0
Mankei-BoarischMundartBairisches ChatmodellApache 2.0
German-OCR-3.1 · 3 · German-OCRLesenVision-OCR für deutsche DokumenteApache 2.0
German-OCR-2B (GGUF)LesenKompaktes Vision-Language-ModellApache 2.0
GOCRLesenLayout-OCR: Text und Positionen als JSON, ONNXApache 2.0
Belegant-4BLesenBelege, Rechnungen, QR-RechnungApache 2.0
CANDefender DoS · Fuzzy · BasisSchützenEinbruchserkennung auf dem CAN-BusCC BY-NC-ND 4.0
SecIDS-v2 · SecIDS-CNNSchützenIntrusion Detection, Automotive und NetzCC BY-NC 4.0
Anomalieerkennung MetallSchützenQualitätsprüfung in der Fertigung, OpenVINOApache 2.0
WakeCoreSprechenAktivierungswort-Erkennung für private SprachsystemeMIT
German-TTSSprechenDeutsche Sprachsynthese mit Stimmklonenauf Anfrage
Lizenzen laut Modellkarte. Modelle unter CC BY-NC sind für den kommerziellen Einsatz auf Anfrage lizenzierbar.
Technologie

Ein Fundament für alle Linien

Was für ein Modell gilt, gilt für alle: eigene Gewichte, eigener Tokenizer, benannte Quellen, Betrieb im eigenen Haus.

Von Grund auf trainiert

Kein fremdes Basismodell, keine geliehene Grundlage: jedes Gewicht ist in Deutschland entstanden — from scratch, auf einer einzelnen Karte. Souveräne Modelle brauchen kein Rechenzentrum.

Eigener deutscher Tokenizer

Ein 32k-Vokabular, auf deutschem Text gebaut statt aus dem Englischen geerbt. Deutsche Wörter bleiben ganz — das Modell liest Deutsch, wie es geschrieben wird.

Offen lizenzierte Daten, Quelle für Quelle

Jede Trainingsquelle ist benannt und mit ihrer Lizenz dokumentiert. Der englische Anteil ist gezielt gewählt: Mathematik, Wissenschaft, Bildung — er verbreitert das Fundament, während Deutsch das Modell trägt.

Die Mankei Schema-Fabrik

Für Reflex: Generatoren, deren Wahrheit aus der modellierten Welt folgt, ergänzt um lizenzierte Datensätze. Ein neuer Block bedeutet neue Daten, nicht ein neues Modell. Ohne Ausgaben von Chatmodellen.

Trainingsquellen · offen lizenziert, quellseitig dokumentiert
QuelleDomäneLizenz
FineWeb2-HQDeutsches Web, Top-FilterODC-BY 1.0
FinePDFsDeutscher PDF-VolltextODC-BY 1.0
Wikipedia (de)EnzyklopädieCC-BY-SA 4.0
German CommonsRecht und WissenschaftODC-BY
FineMath · OpenWebMathMathematik (englisch)ODC-BY 1.0
FineWeb-EduBildung (englisch)ODC-BY 1.0
Der Chat-Feinschliff ist selbst erzeugt und unter CC0 gestellt, gegen ein festes Prüfset dekontaminiert. Die Quellenliste erscheint mit den Gewichten.
Zum Ansehen

Demos, die im Browser laufen

Vier Anwendungen aus drei Linien — ohne Anmeldung, ohne Installation.

Reflex Pilot im Drohnenmodus: Protokoll mit Urteilen über Hindernis, Überfliegbarkeit und Sperrzone.
Reflex Pilot

Fahrzeug und Drohne in einer 3D-Stadt

Ein BMW M4 auf der Straße oder eine Drohne auf der Luftlinie. Der Mensch setzt das Ziel auf der Karte, das Modell urteilt fortlaufend mit — jede Entscheidung erscheint im Protokoll neben der Szene.

Demo öffnen

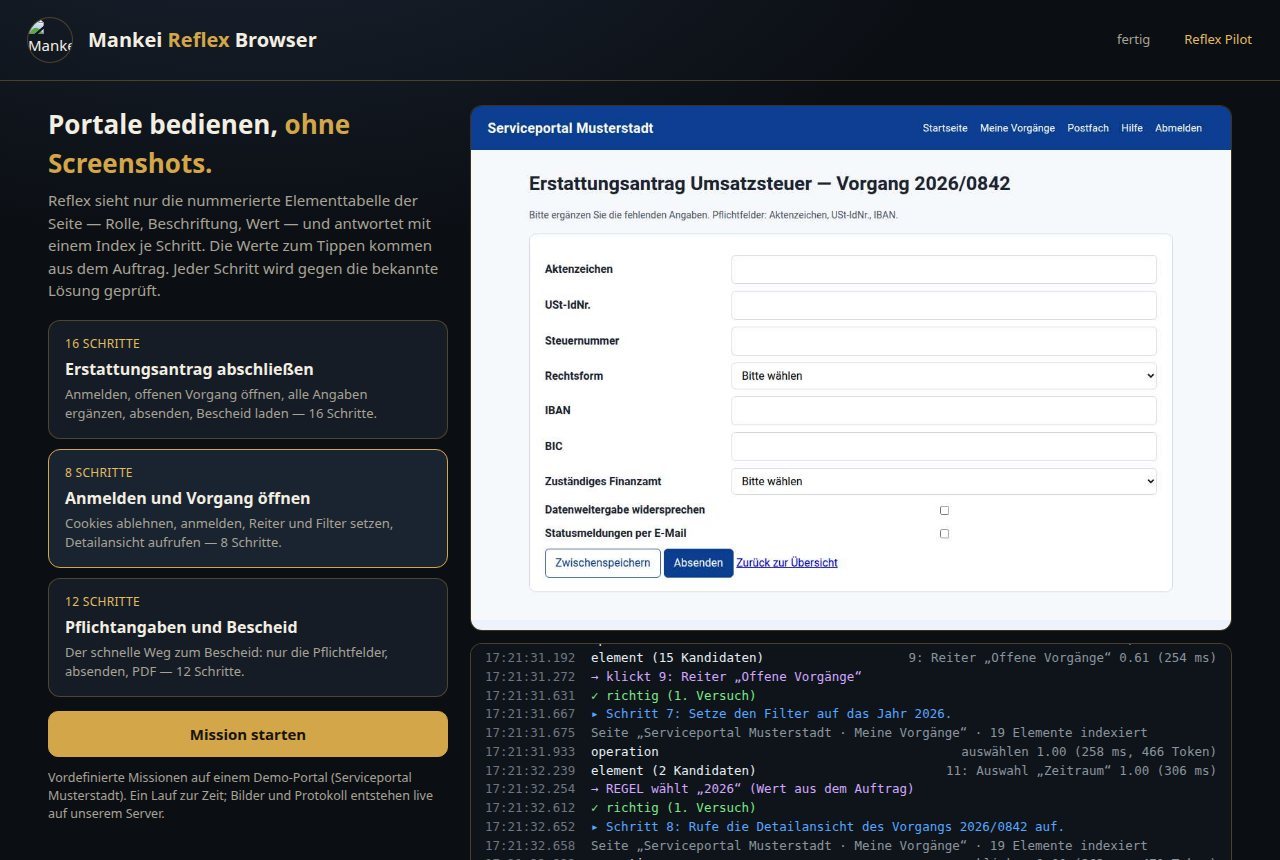
Reflex Browser: Missionen auf einem deutschen Serviceportal, daneben das Schrittprotokoll.
Reflex Browser

Ein deutsches Serviceportal bedienen

Das Modell sieht nur die nummerierte Elementtabelle der Seite — keine Bildschirmfotos, keine Selektoren — und antwortet mit einem Index je Schritt. Sechzehn Schritte in rund hundert Sekunden.

Demo öffnen

Die Dialekt-Demo: Boarisch oder Schwyzerdütsch, unterhalten oder übersetzen.
Dialekt-Demo

Boarisch und Schwyzerdütsch

Mundart wählen und mit Mankei reden — oder einen hochdeutschen Satz in die Mundart übertragen lassen.

Demo öffnen

Dialekt-Fragebogen

Mundart von Sprechern geprüft

Wer Boarisch oder Schwyzerdütsch spricht, beurteilt im Fragebogen, ob ein Satz wirklich so gesagt wird. Aus diesen Urteilen entsteht der nächste Stand der Mundart-Linie.

Fragebogen öffnen
Zusammenarbeit

Partner werden

Die nächsten Ausbaustufen entstehen mit ausgewählten Partnern — in drei konkreten Formen.

Direkt

kontakt@mankei.ai
089 26221842

Keyvan Hardani
Am Westpark 10, 81373 München

Kontakt

Schreiben Sie uns

Wir antworten persönlich. Der Versand läuft über unseren eigenen Server, ohne Formular-Drittdienst.

Versand über unseren eigenen Server, ohne Formular-Drittdienst.